MemOS
Self-evolving memory OS for LLM & AI Agents: ultra-persistent memory, hybrid-retrieval, and cross-task skill reuse, with 35.24% token savings and DeepSeek Harness support.
- 12k
- TypeScript
- Apache-2.0
- 11 h ago
Text2Mem: A Unified Memory Operation Language for Memory Operating System
Repo MemTensor/text2mem, read from GitHub 1 min ago. MemTensor has not joined Take My Repo.
MemTensor/text2mem is a public repo on GitHub by MemTensor. Text2Mem: A Unified Memory Operation Language for Memory Operating System. It declares the MIT license on GitHub. It is written mainly in Python, has 62 stars and last changed on 2026-01-07. Nobody has reviewed it on Take My Repo yet, which says nothing about its quality. Read from GitHub on 2026-11-20.
Turn underspecified memory intents into a validated, auditable JSON IR—portable across providers and storage backends.
English | 中文 | Documentation | Docs Index

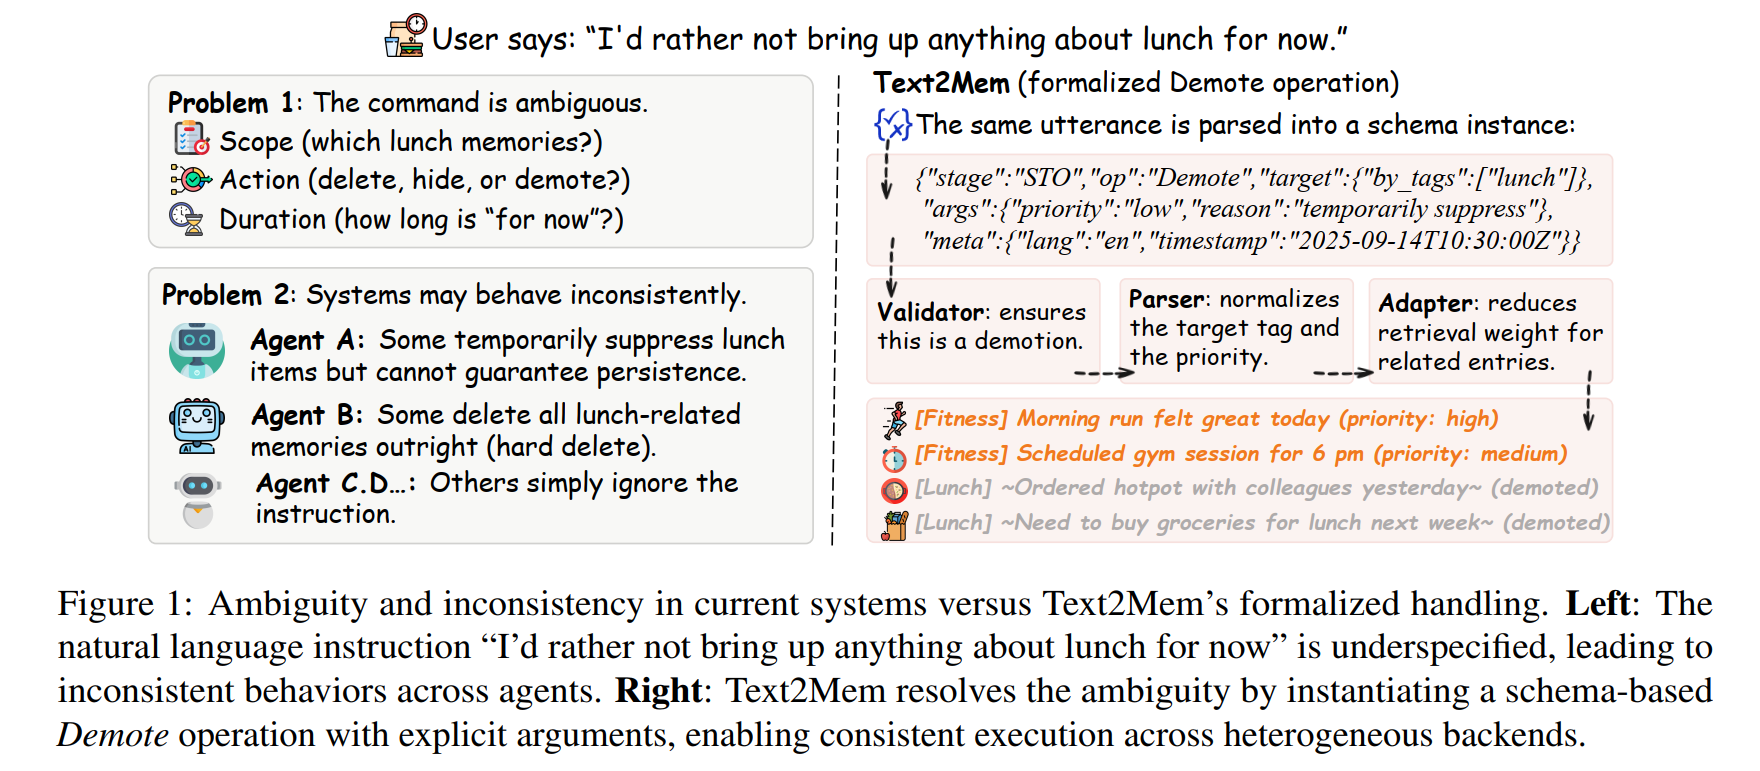
Modern agents struggle with long-term memory control because natural-language instructions are often underspecified (scope, timing, permissions), memory actions are ad-hoc and framework-specific, and there is no stable execution contract between intent and backend behavior.
Text2Mem addresses this by introducing:
stage / op / target / args / meta that fixes execution-relevant decisions before runtime.Use it as a prototyping sandbox, a production memory core, or a teaching reference for memory control.

| Feature | Description |
|---|---|
| 12 Canonical Operations | Encode; Retrieve, Summarize; Storage: Update, Label, Promote, Demote, Merge, Split, Delete, Lock, Expire |
| Clarify (UX utility) | Optional preflight disambiguation step to resolve underspecified instructions before generating IR (not part of the canonical op set) |
| Operation Schema IR | Typed JSON contract with stage/op/target/args/meta |
| Multi-Provider | Mock (testing), Ollama (local), OpenAI (cloud) |
| Semantic Search | Hybrid retrieval: embedding similarity + keyword matching |
| Validation | JSON Schema + Pydantic v2 dual validation, plus safety invariants |
| CLI & Workflows | Single-op execution and multi-step workflows using the same IR |
| Benchmark | Two-layer evaluation: plan-level IR generation + execution-level state/assertion correctness |
# Clone repository
git clone https://github.com/your-username/Text2Mem.git
cd Text2Mem

# Create virtual environment
python -m venv venv
source venv/bin/activate  # Windows: venv\Scripts\activate

# Install package
pip install -e .
# Copy environment template
cp .env.example .env

# Use mock provider (no LLM required)
# Edit .env and ensure: TEXT2MEM_PROVIDER=mock

# Run demo
python manage.py demo
Choose your provider:
cp .env.example .env
# .env content:
# TEXT2MEM_PROVIDER=mock
# Install Ollama: https://ollama.ai
# Pull models
ollama pull nomic-embed-text
ollama pull qwen2:0.5b

# Configure .env
cp .env.example .env
# Edit .env:
# TEXT2MEM_PROVIDER=ollama
# TEXT2MEM_EMBEDDING_MODEL=nomic-embed-text
# TEXT2MEM_GENERATION_MODEL=qwen2:0.5b
# OLLAMA_BASE_URL=http://localhost:11434
cp .env.example .env
# Edit .env:
# TEXT2MEM_PROVIDER=openai
# TEXT2MEM_EMBEDDING_MODEL=text-embedding-3-small
# TEXT2MEM_GENERATION_MODEL=gpt-4o-mini
# OPENAI_API_KEY=your-api-key-here
# Check environment status
python manage.py status

# Expected output:
# ✅ Environment configured
# ✅ Provider: mock/ollama/openai
# ✅ Models loaded
python manage.py ir --inline '{
  "stage":"ENC",
  "op":"Encode",
  "args":{
    "payload":{"text":"Meeting with team about Q4 roadmap"},
    "type":"event",
    "tags":["meeting","roadmap"]
  }
}'
python manage.py ir --inline '{
  "stage":"RET",
  "op":"Retrieve",
  "target":{
    "search":{
      "intent":{"query":"roadmap meeting"},
      "limit":5
    }
  },
  "args":{}
}'
python manage.py ir --inline '{
  "stage":"RET",
  "op":"Summarize",
  "target":{"ids":["1"]},
  "args":{"focus":"brief summary","max_tokens":256}
}'
python manage.py session

# Commands:
> encode "Another important meeting"
> retrieve "meeting" limit=5
> status
> help
> exit
python manage.py workflow path/to/workflow.json

# Output shows each step:
# Step 1/N: ... ✅

┌─────────────────────────────────────────────────┐
│                 Client / CLI                    │
└────────────────────┬────────────────────────────┘
                     │  Natural language / JSON IR
                     ▼
┌─────────────────────────────────────────────────┐
│             Operation Schema (IR)               │
│     {stage, op, target, args, meta}             │
└────────────────────┬────────────────────────────┘
                     ▼
┌─────────────────────────────────────────────────┐
│  Validator → Parser → Adapter (Execution Path)  │
│  - schema validation + safety invariants         │
│  - typed normalization                           │
│  - backend mapping                               │
└────────┬────────────────────────┬────────────────┘
         │                        │
         ▼                        ▼
┌──────────────────┐    ┌──────────────────────┐
│  Model Service   │    │   Storage Adapter    │
│  - Mock/Ollama   │    │   - SQLite (ref)     │
│  - OpenAI        │    │   - Postgres (TODO)  │
└──────────────────┘    └──────────────────────┘
Key Components
stage/op/target/args/meta)# Environment python manage.py status # Show environment status python manage.py config # Interactive configuration # Single IR execution python manage.py ir --inline '<json>' # Execute one IR from inline JSON python manage.py ir --file path.json # Execute from file # Demo python manage.py demo # Run demo workflow # Workflow execution python manage.py workflow <file> # Run multi-step workflow # Interactive mode python manage.py session # Enter REPL # Testing python manage.py test # Run test suite
# View current benchmark info
./bench-cli info

# Run tests
./bench-cli run --mode mock -v

# View results
./bench-cli show-result latest

# List result history
./bench-cli list-results

# Compare two results
./bench-cli compare <id1> <id2>

# Generate new benchmark (advanced)
./bench-cli generate
./bench-cli validate <id> --run-tests
./bench-cli promote <id>
See bench/GUIDE.md for complete benchmark documentation.

Text2Mem Benchmark separates planning from execution:
Common metrics include:
Engineering pipeline:
We welcome contributions! Please see docs/README.md for:
This project is licensed under the MIT License - see LICENSE for details.
现代 AI 助手的长期记忆控制常因自然语言指令欠约束(作用域、时效、权限不明确)而变得不可预测;同时记忆操作往往碎片化且强依赖框架实现,缺少“意图→执行”的稳定契约层。
Text2Mem 的核心思路是:
stage/op/target/args/meta),在运行前把 scope/参数/权限说清楚。既可用于原型验证,也可作为生产记忆内核或教学参考。
| 功能 | 说明 |
|---|---|
| 12 个标准操作 | Encode;Retrieve、Summarize;存储治理:Update、Label、Promote、Demote、Merge、Split、Delete、Lock、Expire |
| Clarify(体验增强) | 可选的“预澄清/消歧”步骤,用于在生成 IR 前补足欠约束信息(不属于标准操作集) |
| 操作契约 IR | stage/op/target/args/meta 五元 schema |
| 多 Provider | Mock(测试)、Ollama(本地)、OpenAI(云端) |
| 语义检索 | 混合检索:向量相似度 + 关键词匹配 |
| 强校验 | JSON Schema + Pydantic v2 + 安全不变量 |
| CLI & 工作流 | 单操作与多步骤工作流都基于同一 IR |
| 基准评测 | 计划层(生成 IR)+ 执行层(状态/断言正确性)的两层评测 |
# 克隆仓库
git clone https://github.com/your-username/Text2Mem.git
cd Text2Mem

# 创建虚拟环境
python -m venv venv
source venv/bin/activate  # Windows: venv\Scripts\activate

# 安装
pip install -e .
# 复制环境配置
cp .env.example .env

# 使用 mock provider(无需 LLM)
# 编辑 .env 确保: TEXT2MEM_PROVIDER=mock

# 运行演示
python manage.py demo
选择 Provider:
cp .env.example .env
# .env 内容:
# TEXT2MEM_PROVIDER=mock
# 安装 Ollama: https://ollama.ai
# 拉取模型
ollama pull nomic-embed-text
ollama pull qwen2:0.5b

# 配置 .env
cp .env.example .env
# 编辑 .env:
# TEXT2MEM_PROVIDER=ollama
# TEXT2MEM_EMBEDDING_MODEL=nomic-embed-text
# TEXT2MEM_GENERATION_MODEL=qwen2:0.5b
# OLLAMA_BASE_URL=http://localhost:11434
cp .env.example .env
# 编辑 .env:
# TEXT2MEM_PROVIDER=openai
# TEXT2MEM_EMBEDDING_MODEL=text-embedding-3-small
# TEXT2MEM_GENERATION_MODEL=gpt-4o-mini
# OPENAI_API_KEY=你的-API-密钥
# 检查环境状态
python manage.py status

# 预期输出:
# ✅ 环境已配置
# ✅ Provider: mock/ollama/openai
# ✅ 模型已加载
python manage.py ir --inline '{
  "stage":"ENC",
  "op":"Encode",
  "args":{
    "payload":{"text":"团队会议讨论 Q4 路线图"},
    "type":"event",
    "tags":["会议","路线图"]
  }
}'
python manage.py ir --inline '{
  "stage":"RET",
  "op":"Retrieve",
  "target":{
    "search":{
      "intent":{"query":"路线图 会议"},
      "limit":5
    }
  },
  "args":{}
}'
python manage.py ir --inline '{
  "stage":"RET",
  "op":"Summarize",
  "target":{"ids":["1"]},
  "args":{"focus":"简要摘要","max_tokens":256}
}'
python manage.py session

# 命令:
> encode "另一个重要会议"
> retrieve "会议" limit=5
> status
> help
> exit
python manage.py workflow path/to/workflow.json

# 输出显示每个步骤:
# 步骤 1/N: ... ✅
┌─────────────────────────────────────────────────┐
│              客户端 / CLI                       │
└────────────────────┬────────────────────────────┘
                     │  自然语言 / JSON IR
                     ▼
┌─────────────────────────────────────────────────┐
│              操作契约 (IR)                      │
│     {stage, op, target, args, meta}             │
└────────────────────┬────────────────────────────┘
                     ▼
┌─────────────────────────────────────────────────┐
│  Validator → Parser → Adapter(执行路径)       │
│  - schema 校验 + 安全不变量                      │
│  - typed 归一化                                   │
│  - 后端映射                                       │
└────────┬────────────────────────┬────────────────┘
         │                        │
         ▼                        ▼
┌──────────────────┐    ┌──────────────────────┐
│     模型服务      │    │     存储适配器       │
│  - Mock/Ollama    │    │   - SQLite(参考)   │
│  - OpenAI         │    │   - Postgres(TODO) │
└──────────────────┘    └──────────────────────┘
核心组件
stage/op/target/args/meta)# 环境 python manage.py status # 显示环境状态 python manage.py config # 交互式配置 # 单个 IR 执行 python manage.py ir --inline '<json>' # 从内联 JSON 执行一个 IR python manage.py ir --file 路径.json # 从文件执行 # 演示 python manage.py demo # 运行演示工作流 # 工作流执行 python manage.py workflow <文件> # 运行多步骤工作流 # 交互模式 python manage.py session # 进入 REPL # 测试 python manage.py test # 运行测试套件
# 查看当前 benchmark 信息
./bench-cli info

# 运行测试
./bench-cli run --mode mock -v

# 查看结果
./bench-cli show-result latest

# 列出结果历史
./bench-cli list-results

# 对比两个结果
./bench-cli compare <id1> <id2>

# 生成新 benchmark(高级)
./bench-cli generate
./bench-cli validate <id> --run-tests
./bench-cli promote <id>
详见 bench/GUIDE.md。
详见 bench/GUIDE.md。
Text2Mem Benchmark 将评测拆为两层:
常用指标:
工程流水线:
欢迎贡献!详见 docs/README.md:
本项目采用 MIT 许可证 - 详见 LICENSE。
Built with ❤️ for better AI memory management 为更好的 AI 记忆管理而构建
MemTensor/text2mem is a public repo on GitHub by MemTensor. Text2Mem: A Unified Memory Operation Language for Memory Operating System.
It declares the MIT license on GitHub.
Its maker has not tagged a system, so it is unknown here. Its README says what it needs.
Open "Take it" on its page: Take My Repo writes an install plan for your machine and hands it to your AI agent (Claude Code, Codex or Cursor), which asks you before each step. Take My Repo has not tested it on any machine.
Its last change on GitHub was on 2026-01-07. Take My Repo does not judge from that whether it is maintained.
Nobody has reviewed it on Take My Repo yet, which says nothing about its quality.
Self-evolving memory OS for LLM & AI Agents: ultra-persistent memory, hybrid-retrieval, and cross-task skill reuse, with 35.24% token savings and DeepSeek Harness support.
🍙 A personal AI agent & local memory hub for all AI agents, gives every AI one shared, fully controlled memory and persistent context — all AI remember the same you. Now supports Claude Code, Codex, OpenClaw and Hermes Agent etc.
Official MemOS Cloud plugin for OpenClaw. Enables long-term memory for agents by recalling context before execution and saving conversations after each run.
SkillsVote: Lifecycle Governance of Agent Skills from Collection, Recommendation to Evolution
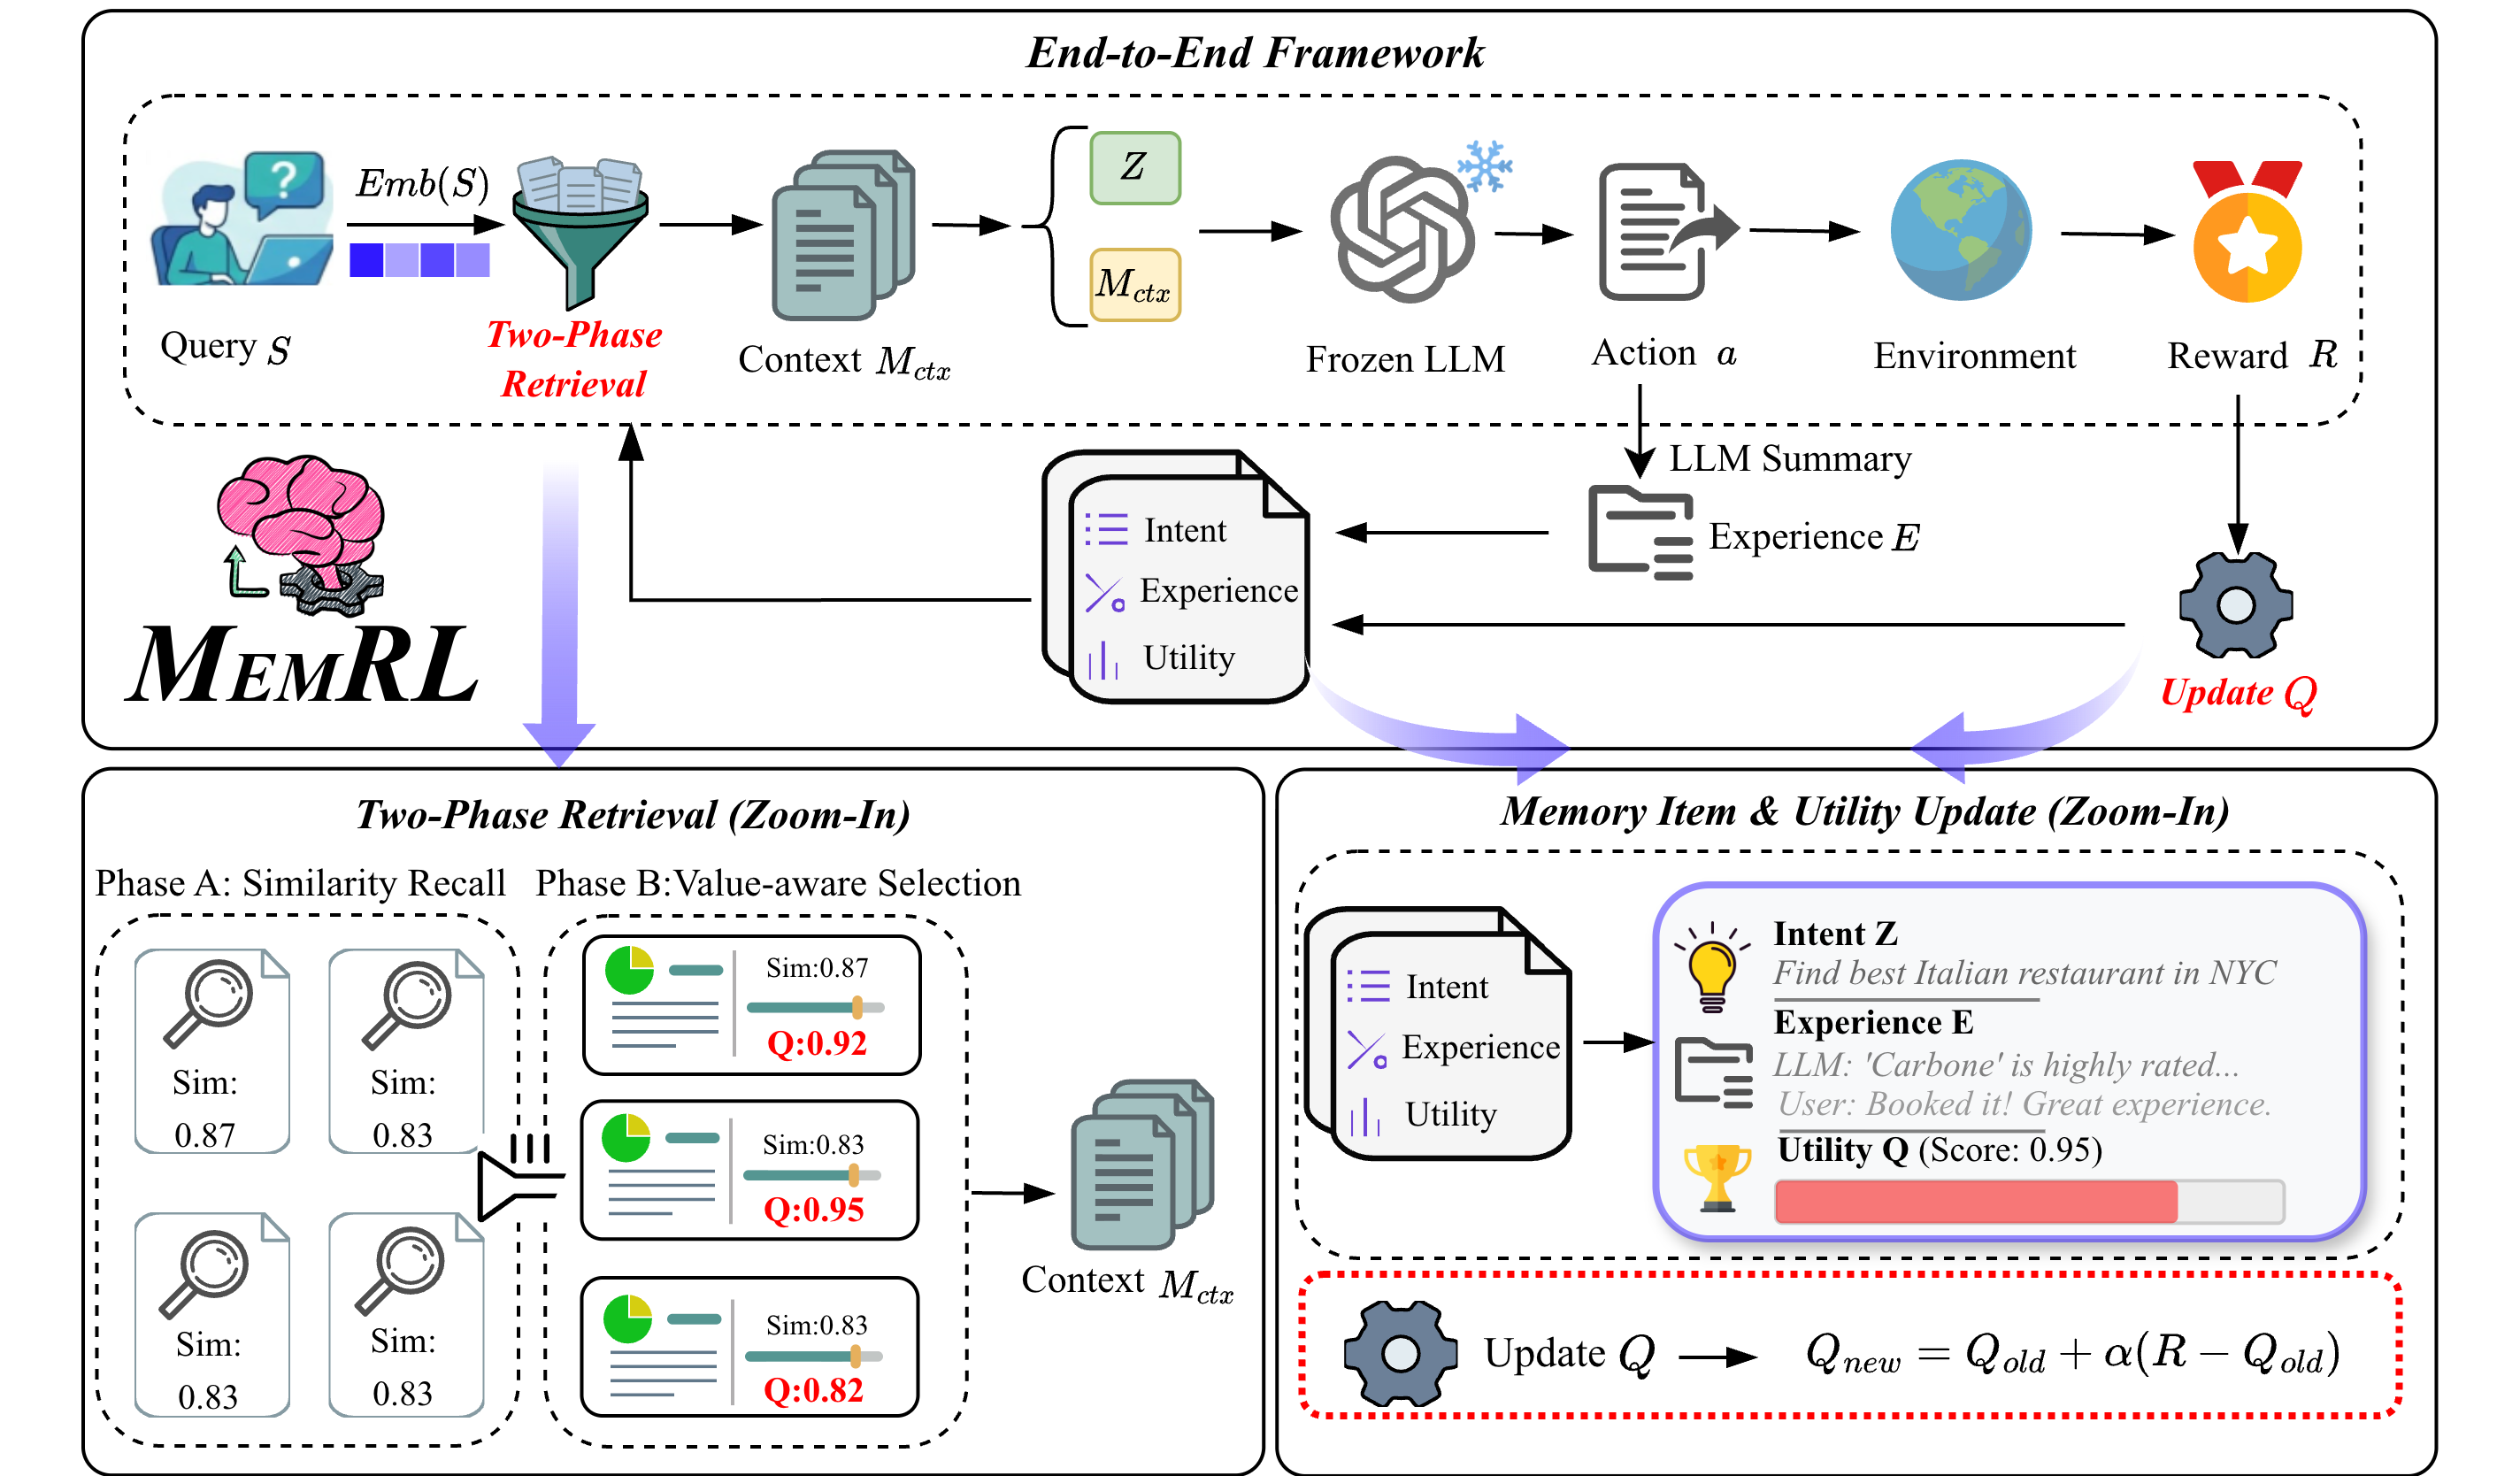
Paper: “MEMRL: SELF-EVOLVING AGENTS VIA RUNTIME REINFORCEMENT LEARNING ON EPISODIC MEMORY” Open-Source Code