📋 目录
🎯 项目简介
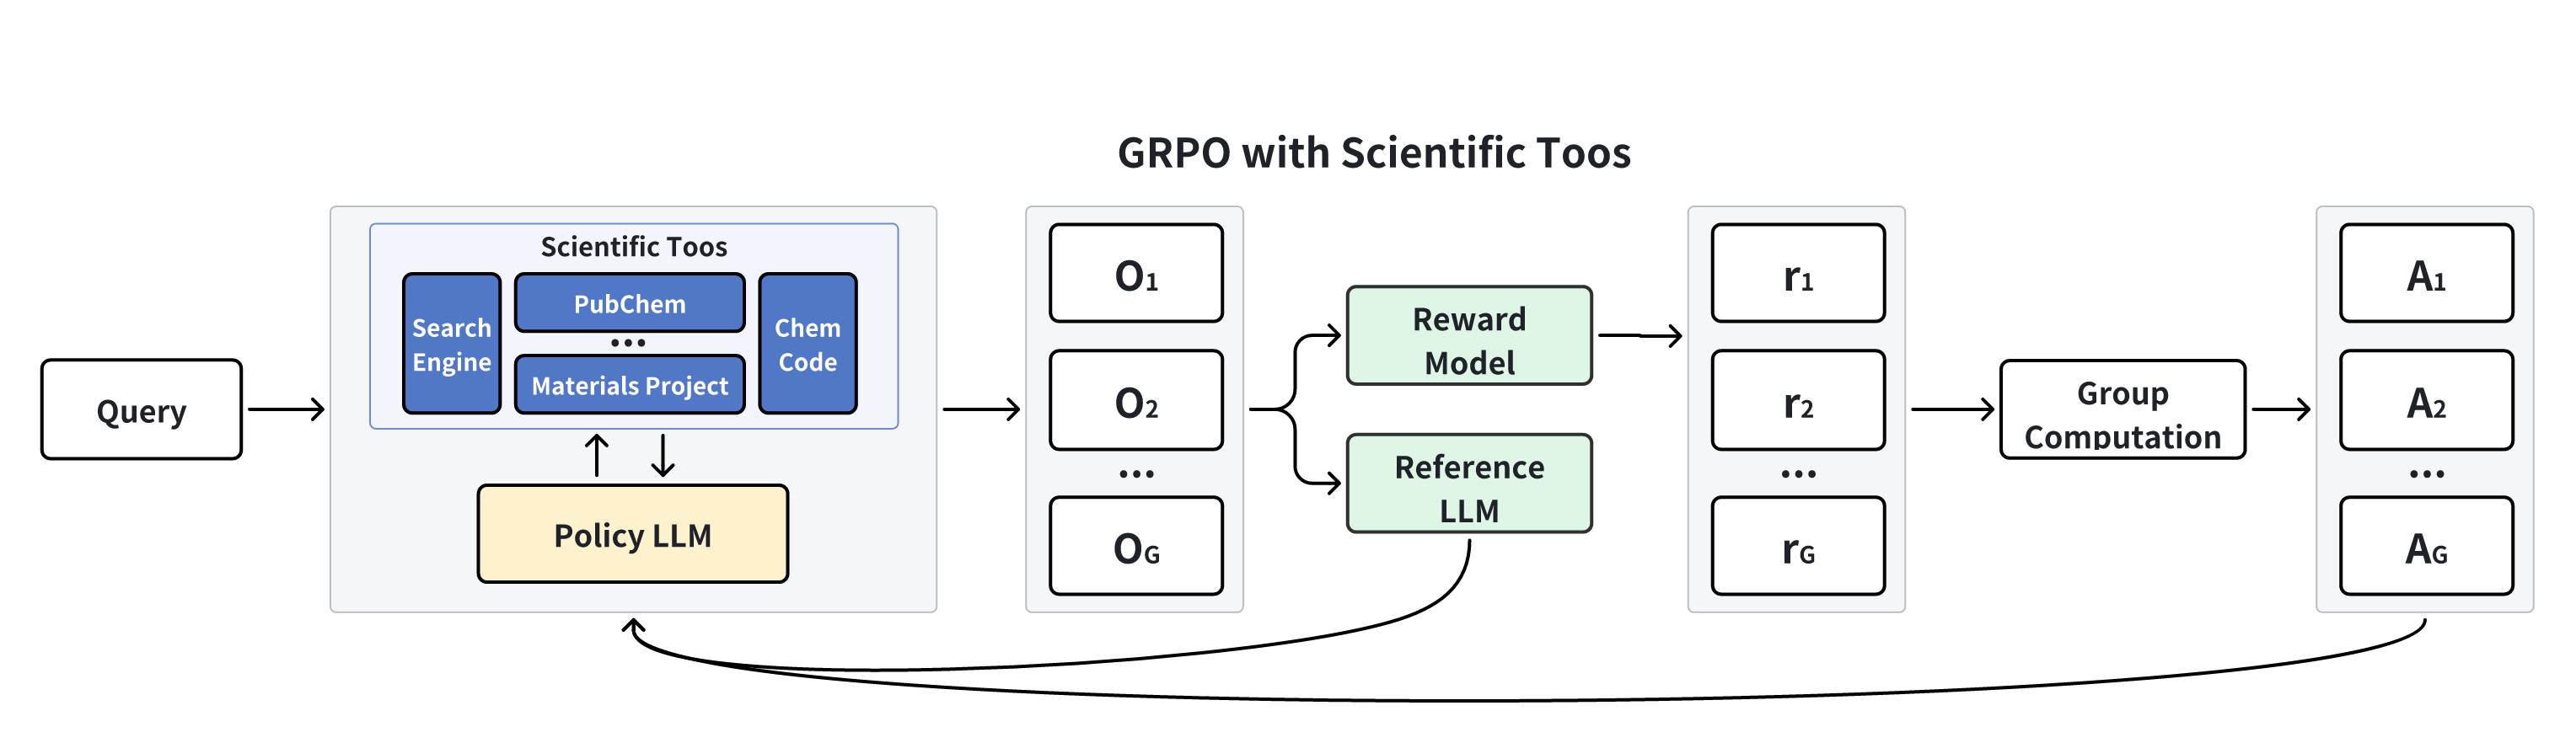
MixReason 是一种提升大语言模型推理能力的方法,该方法能够让模型在思考过程中自主决定调用搜索工具或生成代码,并结合外部工具执行结果优化推理路径,从而高效解决科学领域的复杂问题。
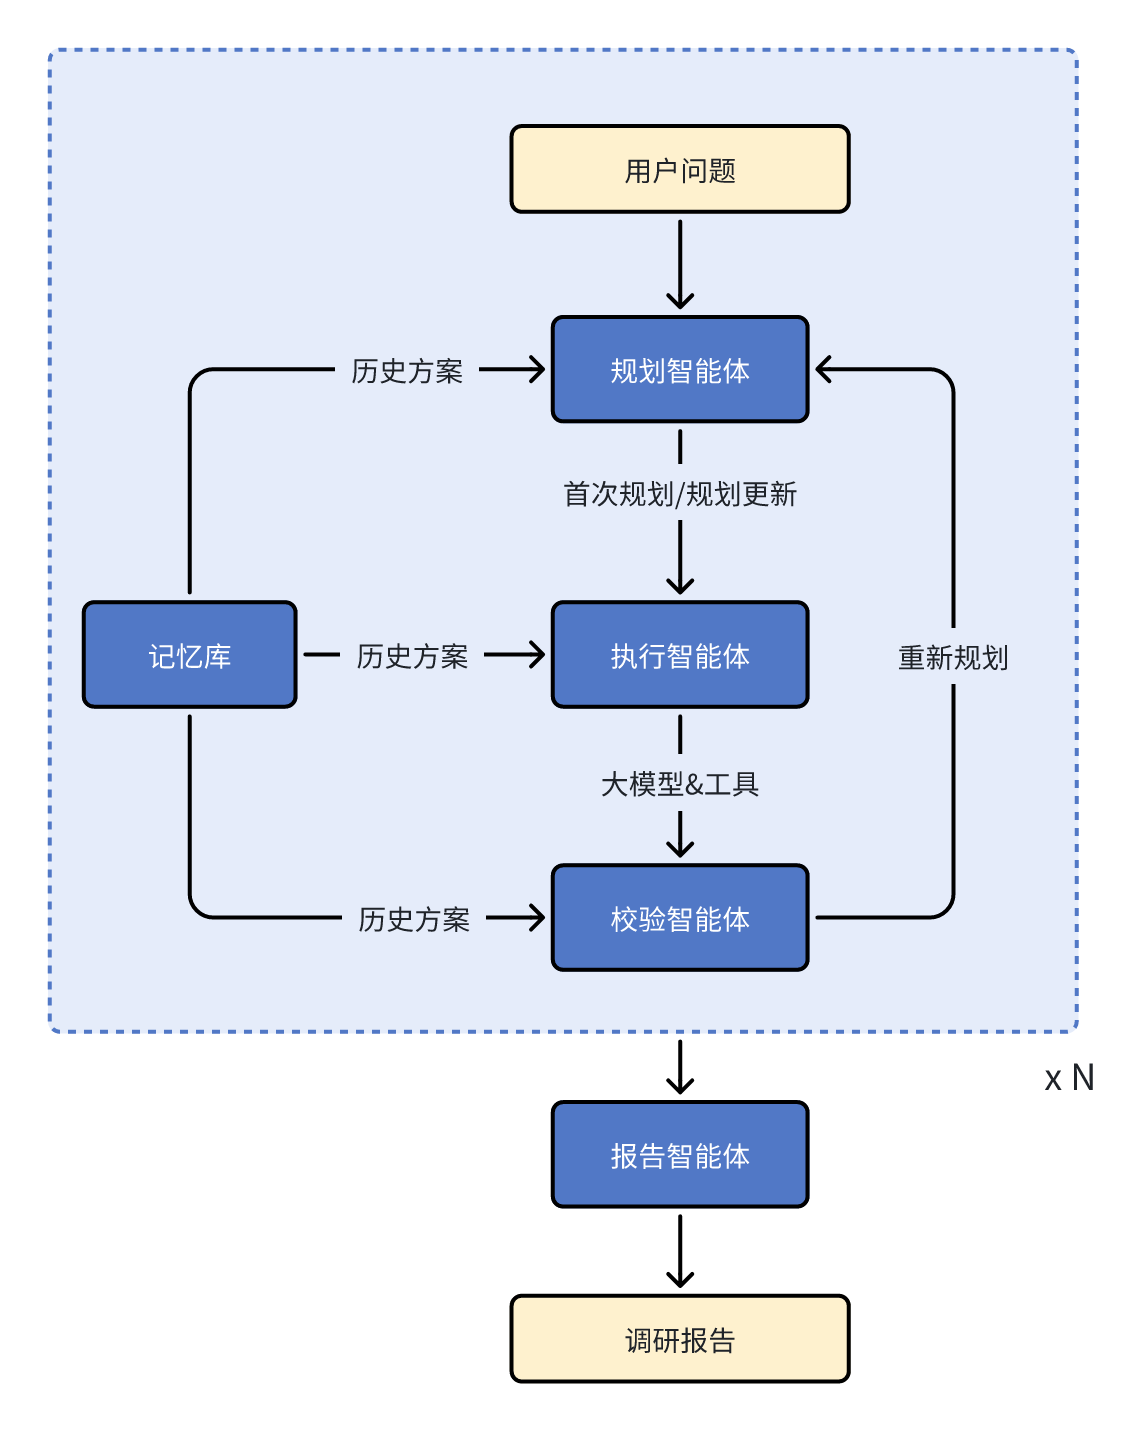
S1-MixReason-8B 是一个基于 Qwen3-8B 使用该方法训练的科学领域大模型,实现边思考、边搜索、边写代码。该模型采用两阶段训练策略:首先进行有监督微调(SFT),然后使用 verl 框架进行如图所示的 GRPO 强化学习训练,最终得到一个能够通过在思考过程中结合调用搜索或生成代码解决科学领域问题的大模型。
📁 项目结构
S1-MixReason-8B/
├── scripts/                    # 训练脚本
│   ├── sft/                    # SFT训练配置
│   └── grpo/                   # GRPO训练脚本
├── evaluation/                 # 推理评测
│   ├── vllm_server.sh          # vLLM服务启动脚本
│   ├── fastapi_service.py      # 推理API服务
│   ├── vllm_api_test.py        # 推理测试脚本
│   └── code_executor_fastapi/  # 代码执行器
├── verl/                       # verl强化学习框架
├── requirements.txt            # 项目依赖
└── README.md                   # 项目说明
📊 模型效果
下表展示了 S1-MixReason-8B 在 TOMG-Bench 基准测试中与其他模型的性能对比:
| 任务 |
Qwen3-235B-A22B |
Qwen3-32B |
Deepseek-R1 |
doubao-1.5-thinking-pro |
Qwen3-8B |
S1-MixReason-SFT-8B |
S1-MixReason-8B |
| AtomNum(根据原子生成) |
0.54 |
0.27 |
0.52 |
0.48 |
0.29 |
0.22 |
0.45 |
| BondNum(根据化学键生成) |
0.44 |
0.36 |
0.45 |
0.46 |
0.15 |
0.22 |
0.25 |
| FunctionalGroup(根据基团生成) |
0.21 |
0.22 |
0.30 |
0.22 |
0.33 |
0.5 |
0.6 |
| AddComponent(添加功能基团) |
0.67 |
0.49 |
0.68 |
0.44 |
0.29 |
0.61 |
0.93 |
| DelComponent(删除功能基团) |
0.80 |
0.57 |
0.83 |
0.74 |
0.72 |
0.73 |
0.9 |
| SubComponent(替换功能基团) |
0.70 |
0.64 |
0.84 |
0.51 |
0.35 |
0.68 |
0.87 |
| LogP(辛醇-水分配系数,亲脂性的一种度量) |
0.85 |
0.58 |
0.84 |
0.68 |
0.37 |
0.68 |
0.94 |
| MR(分子折射率,摩尔折射率的一种替代物) |
0.80 |
0.59 |
0.81 |
0.80 |
0.29 |
0.68 |
0.96 |
| QED(药物相似性的定量估计,类药物特征的评估) |
0.49 |
0.41 |
0.60 |
0.55 |
0.19 |
0.49 |
0.82 |
| All_Acc |
0.61 |
0.46 |
0.65 |
0.54 |
0.33 |
0.53 |
0.75 |
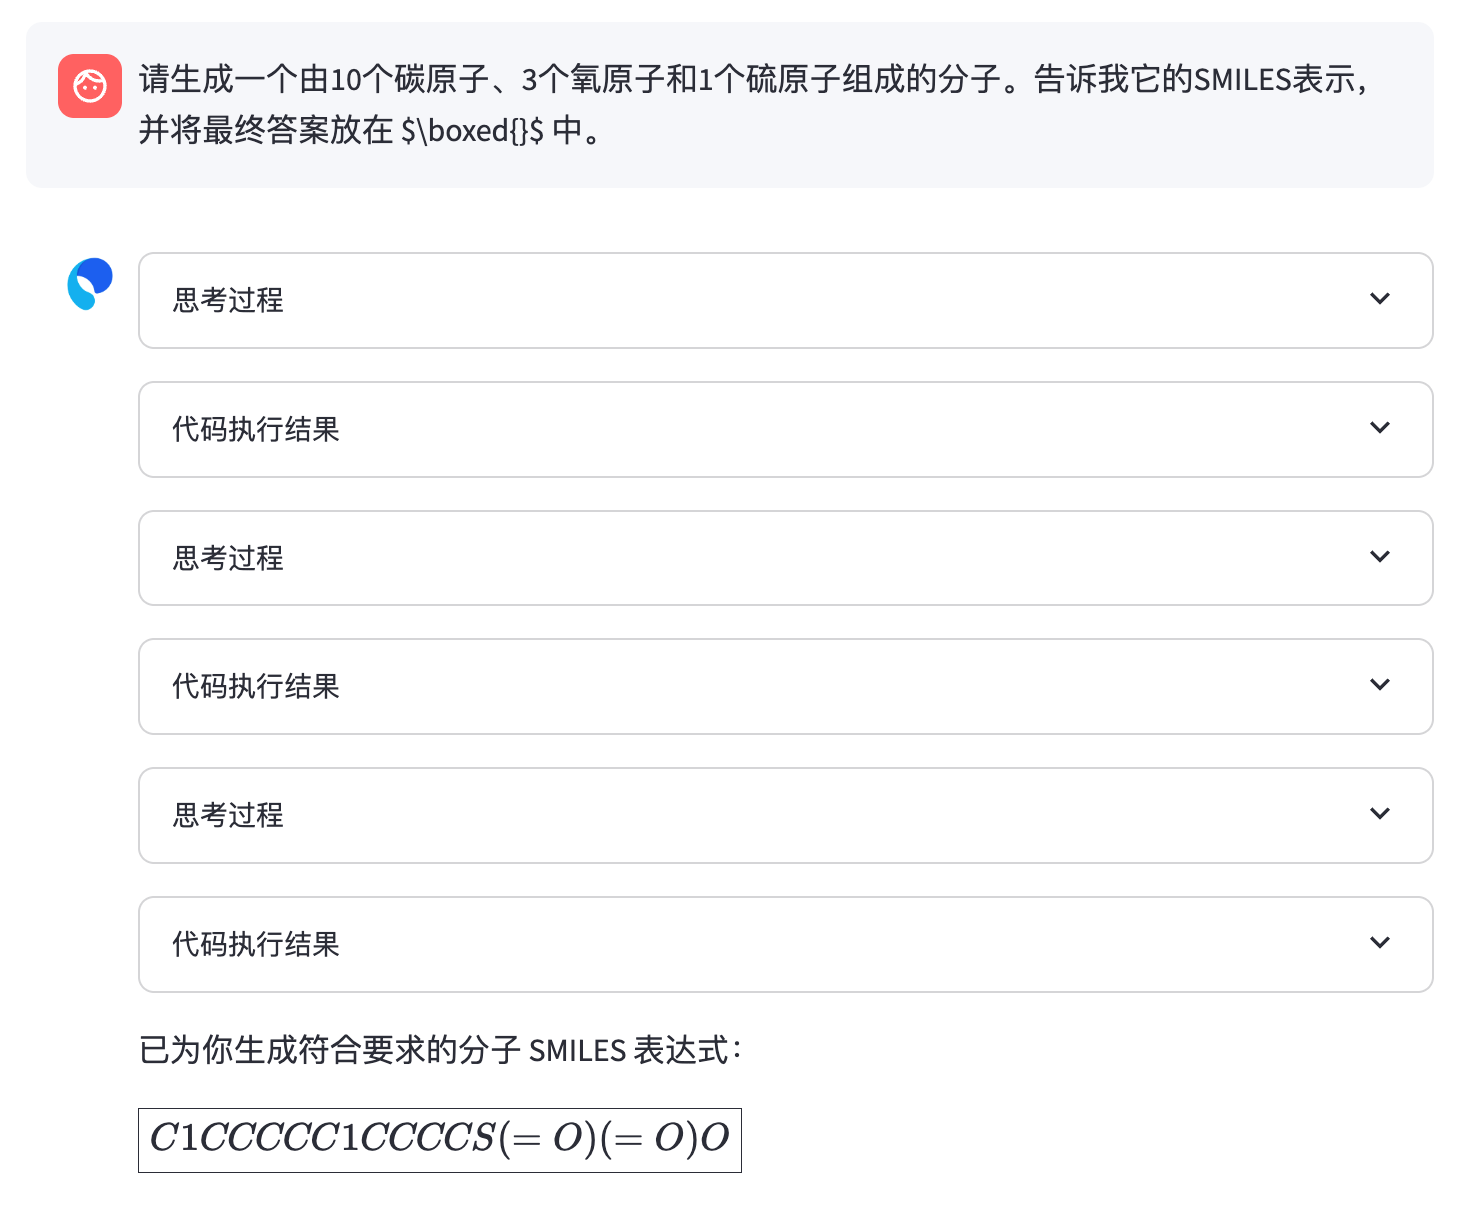
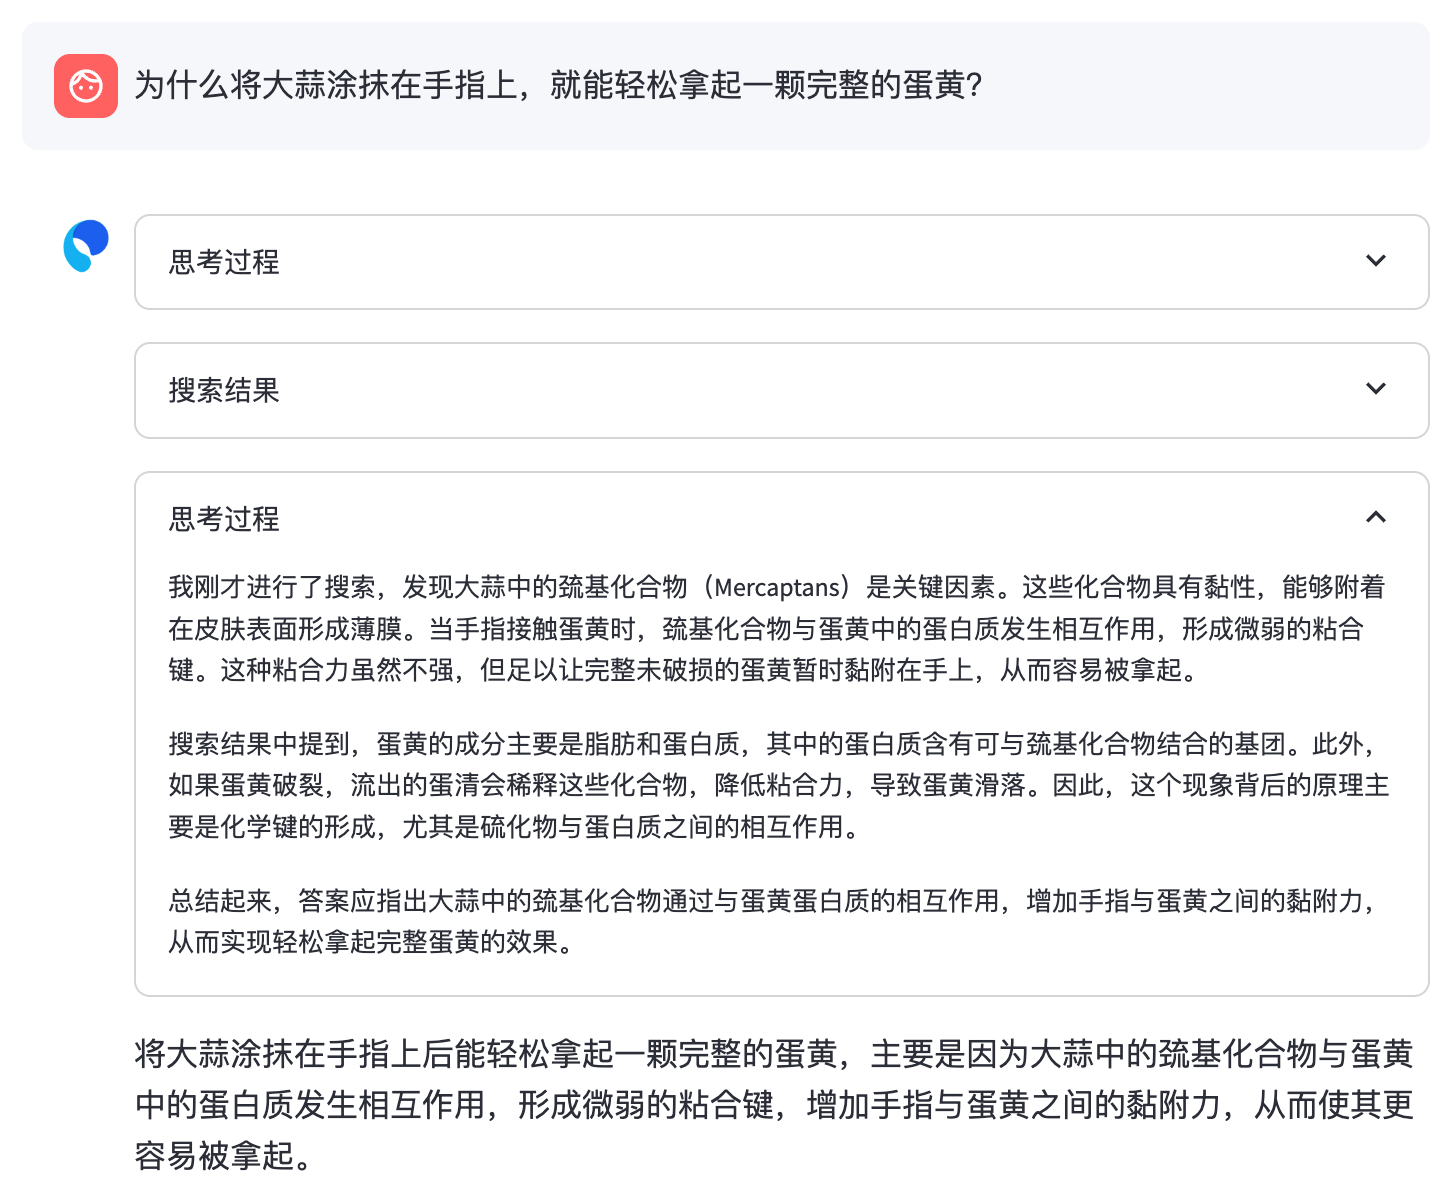
💡 下面是模型在思考过程中借助 ChemCode 代码工具解决问题的示例(点击查看完整示例),以及模型在思考过程中通过 SearchEngine 搜索工具解决问题的示例(点击查看完整示例)。
| ChemCode |
SearchEngine |
 |
 |
🛠️ 环境安装
系统要求
安装步骤
- 克隆项目
git clone https://github.com/ScienceOne-AI/MixReason.git
cd MixReason
- 创建虚拟环境
conda create -n mixreason python=3.10
conda activate mixreason
- 安装依赖
pip install -r requirements.txt
- 安装verl框架
cd verl
pip install -e .
cd ..
🚀 训练步骤
数据准备
在开始训练之前,需要准备以下数据:
- SFT训练数据:用于监督微调的数据集
- GRPO训练数据:用于强化学习训练的数据集
数据格式请参考 verl 框架的数据准备文档。
本地提供参考数据格式:
- SFT训练数据: data/sft/train.json
- GRPO训练数据: data/grpo/train.parquet(由train.json转化)
SFT训练
使用 LLaMA Factory 进行监督微调训练:
# 使用提供的配置文件进行训练
llamafactory-cli train scripts/sft/qwen3_full_sft.yaml
主要配置参数:
- 模型:Qwen3-8B
- 训练数据:tools_sft_data0712
- 输出目录:/path/to/sft/output
- 训练轮数:1 epoch
- 学习率:1e-4
GRPO训练
搜索工具
Quark API -- verl/verl/workers/rollout/vllm_rollout/web_search/web_search_main.py
def quark_search(query) -> List[Dict[str, Any]]:
    """
    使用阿里云 IQS 接口进行统一搜索,返回搜索结果列表。
    :param query: 搜索关键词,例如"杭州美食"
    :return: 包含搜索结果的字典列表
    """
    def create_client() -> Client:
        load_dotenv(find_dotenv())
        config = open_api_models.Config(
            # 推荐使用环境变量方式管理 AK/SK
            access_key_id="xxx",
            access_key_secret="xxx"
        )
        config.endpoint = 'iqs.cn-xxx.aliyuncs.com'
        return Client(config)
使用 verl 框架进行 GRPO 强化学习训练:
# 单节点训练
bash scripts/grpo/train_grpo.sh

# 多节点训练(使用SLURM)
bash scripts/grpo/slurm_multi_node.sh
主要配置参数:
- 基础模型:SFT训练后的模型
- 训练数据:GRPO训练数据集
- 算法:GRPO
- 奖励函数:re_search
- 训练轮数:1 epoch
🔍 推理评测
启动 vLLM 服务
首先启动 vLLM 推理服务:
# 修改 evaluation/vllm_server.sh 中的模型路径
# 然后启动服务
bash evaluation/vllm_server.sh
服务将在端口6537上运行,支持以下功能:
- 最大序列长度:32768
- GPU内存利用率:0.9
- 张量并行度:8
启动代码沙盒
启动代码执行器服务:
# 后台启动代码沙箱执行器
cd evaluation/code_executor_fastapi/app
nohup python code_executor_fastapi.py > nohup.out 2>&1 &
启动推理 API
启动 FastAPI 推理服务:
cd evaluation
nohup python fastapi_service.py > server.log 2>&1 &
服务将在端口 8008 上运行,提供以下API端点:
POST /v1/chat/completions:主要推理接口
测试推理
使用提供的测试脚本验证推理功能:
cd evaluation
python vllm_api_test.py
测试脚本会发送示例查询并验证模型响应。
📄 开源协议
本项目基于 Apache-2.0 License 开源发布,欢迎学术与商业使用。
🤝 致谢
本项目基于 Llama Factory、verl、Tool-Star 等开源项目开发,评测基准参考 TOMG-Bench,基础模型为 Qwen3。感谢所有开源社区的贡献!