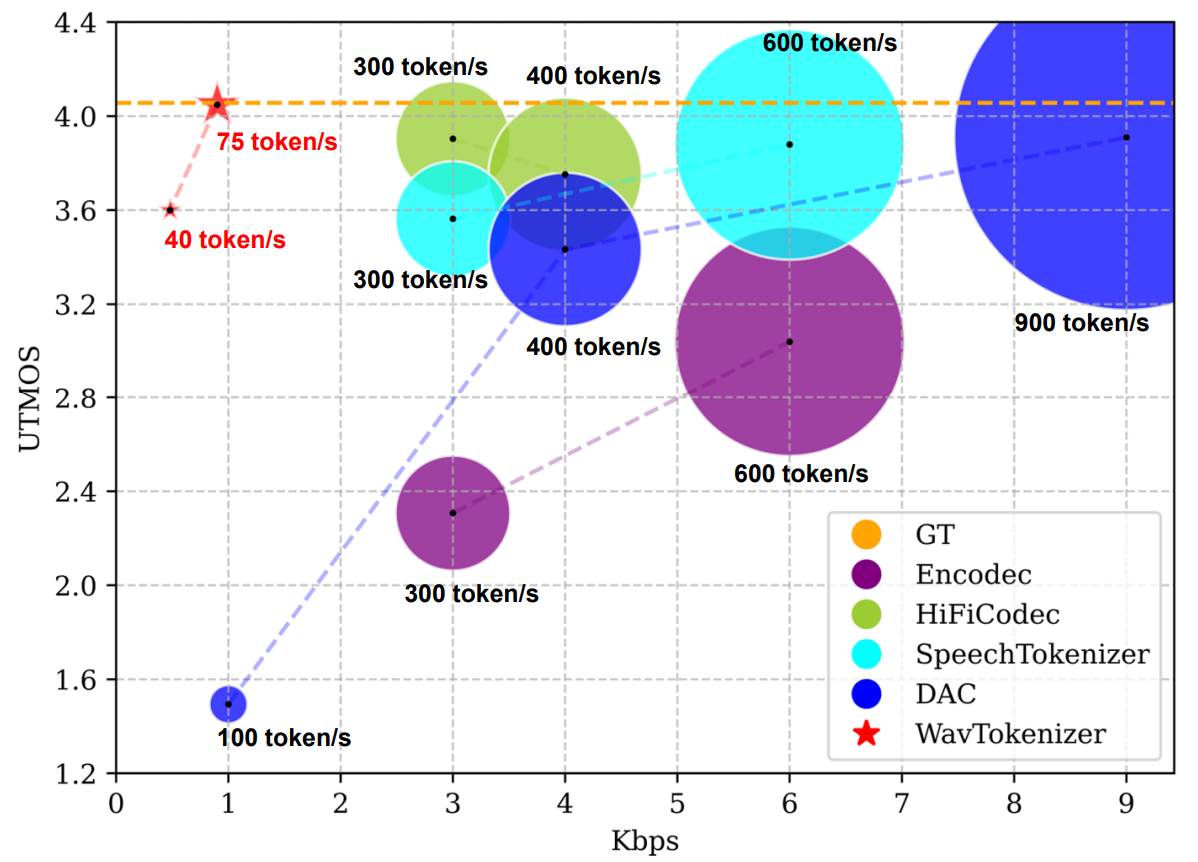
Voice and audioRepoWavTokenizer[ICLR 2025] SOTA discrete acoustic codec models with 40/75 tokens per second for audio language modeling acousticaudio-representationcodec1.3kPythonMIT21 mo agojishengpengShare or keepTake it