vid-TLDR
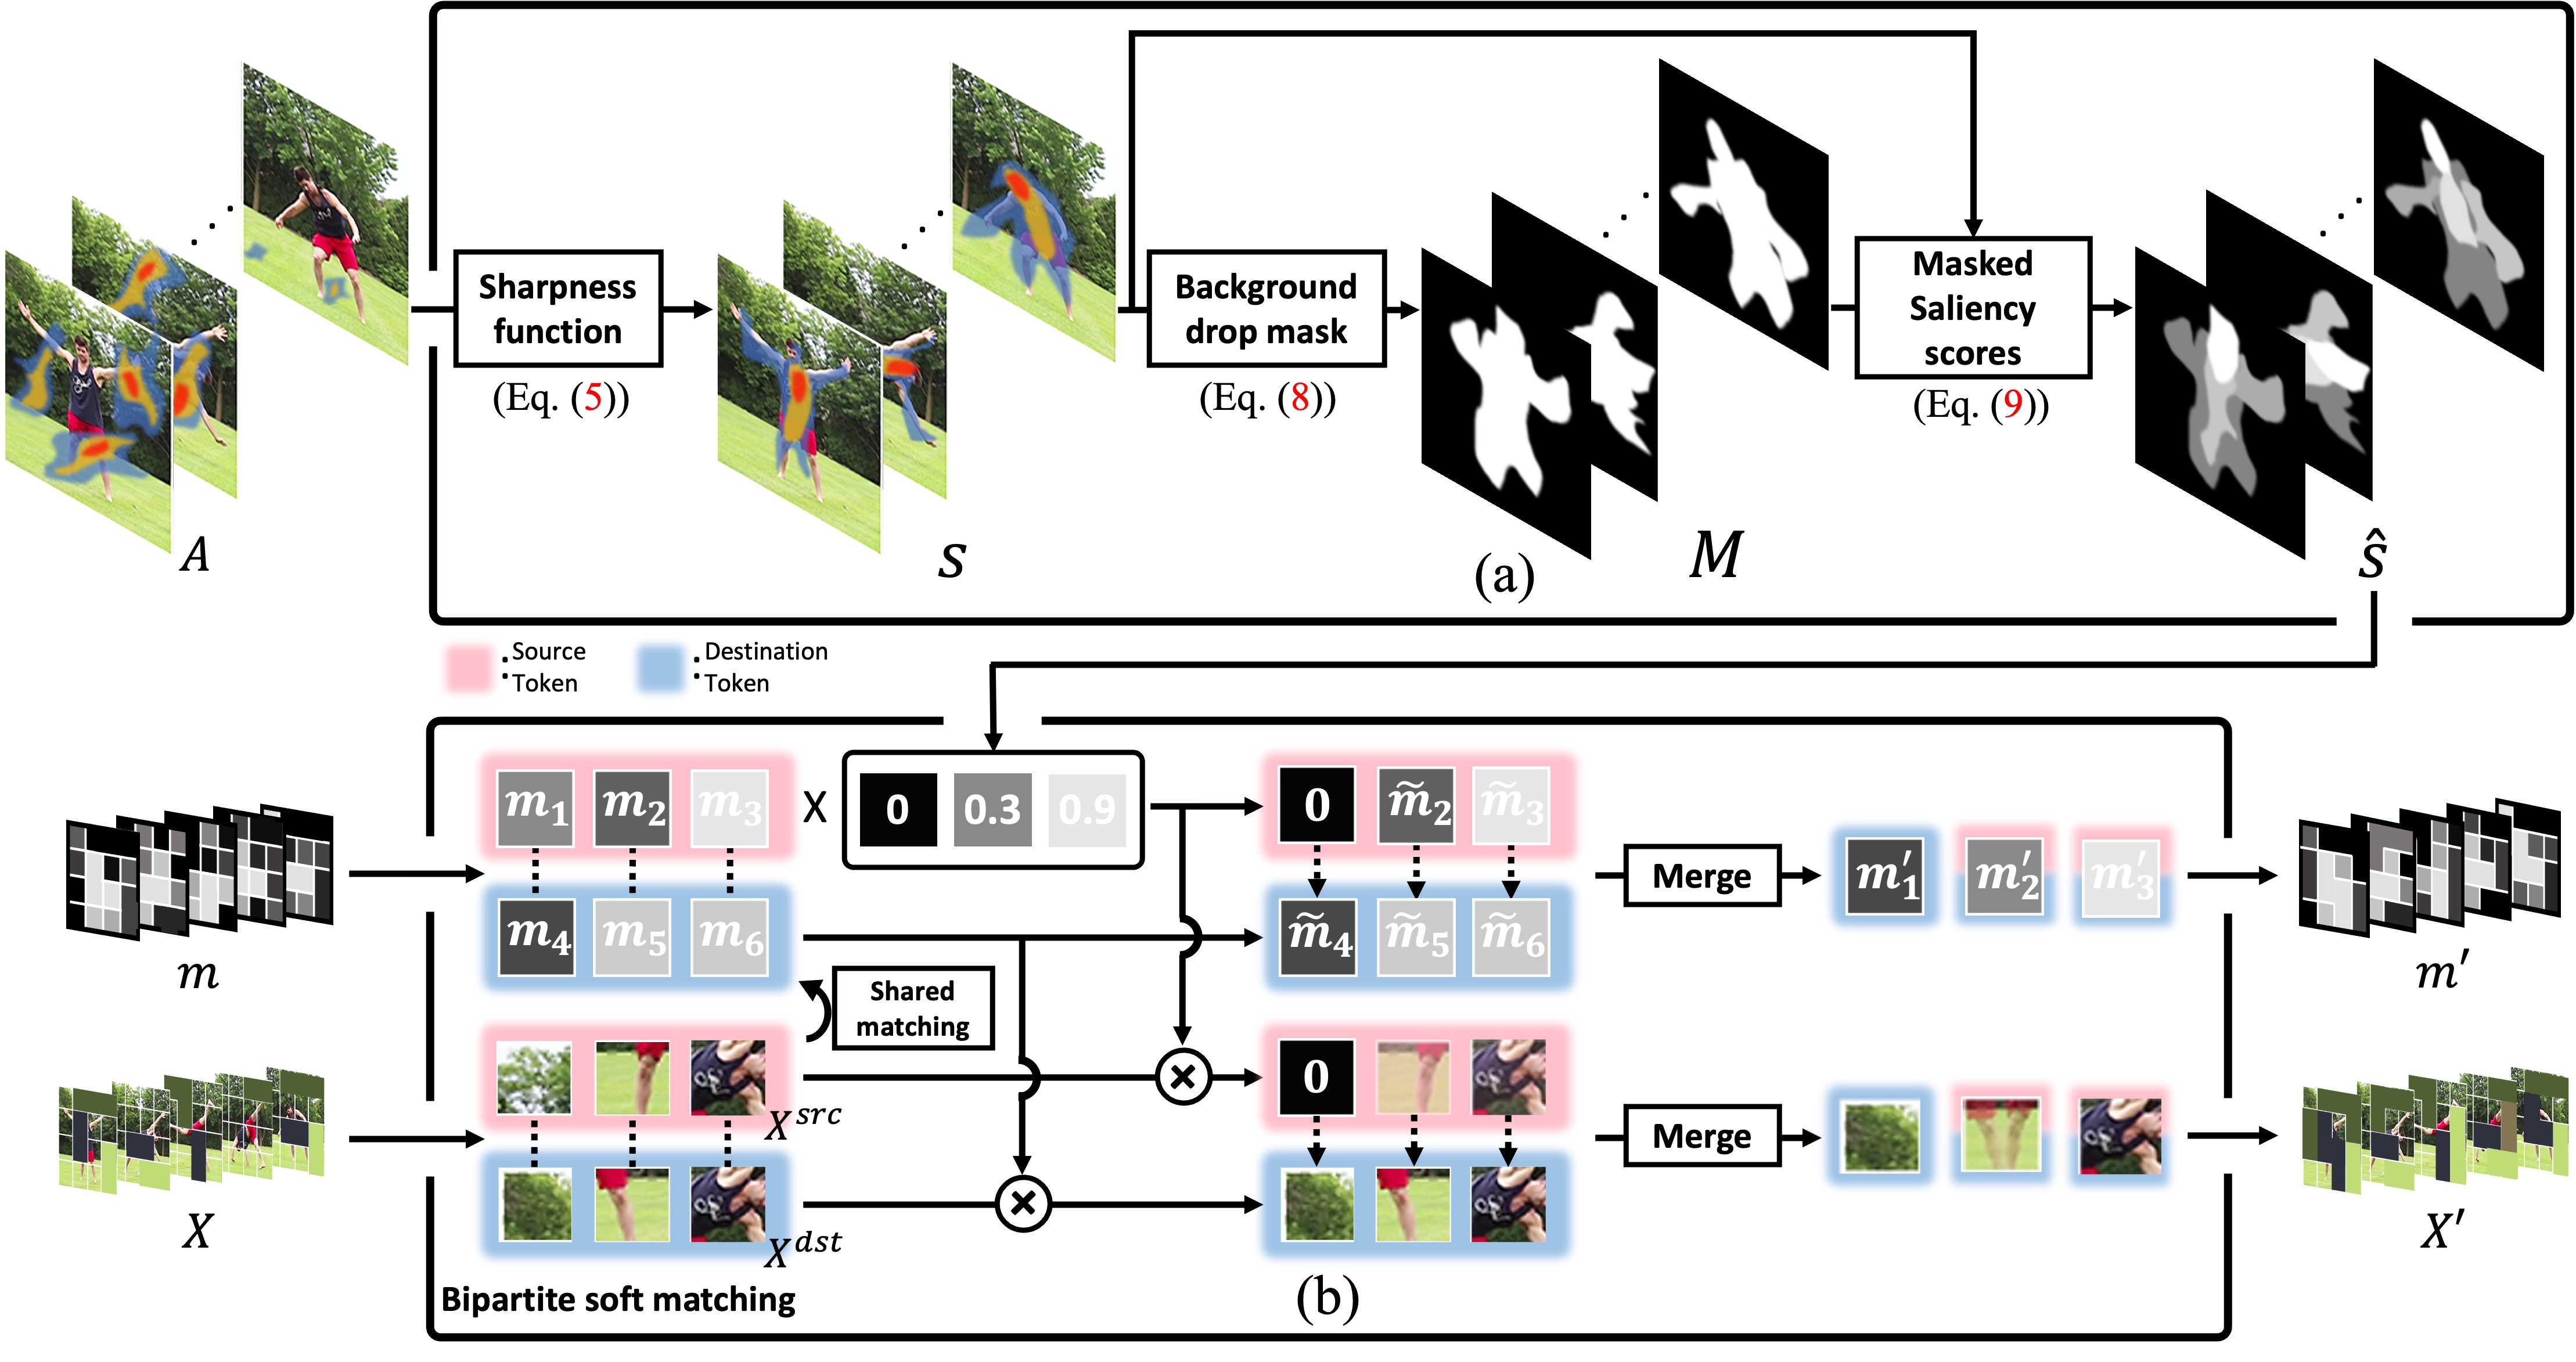
Official implementation of CVPR 2024 paper "vid-TLDR: Training Free Token merging for Light-weight Video Transformer".
- 56
- Python
- MIT
- 13 mo ago
Official implementation of CVPR 2024 paper "vid-TLDR: Training Free Token merging for Light-weight Video Transformer".
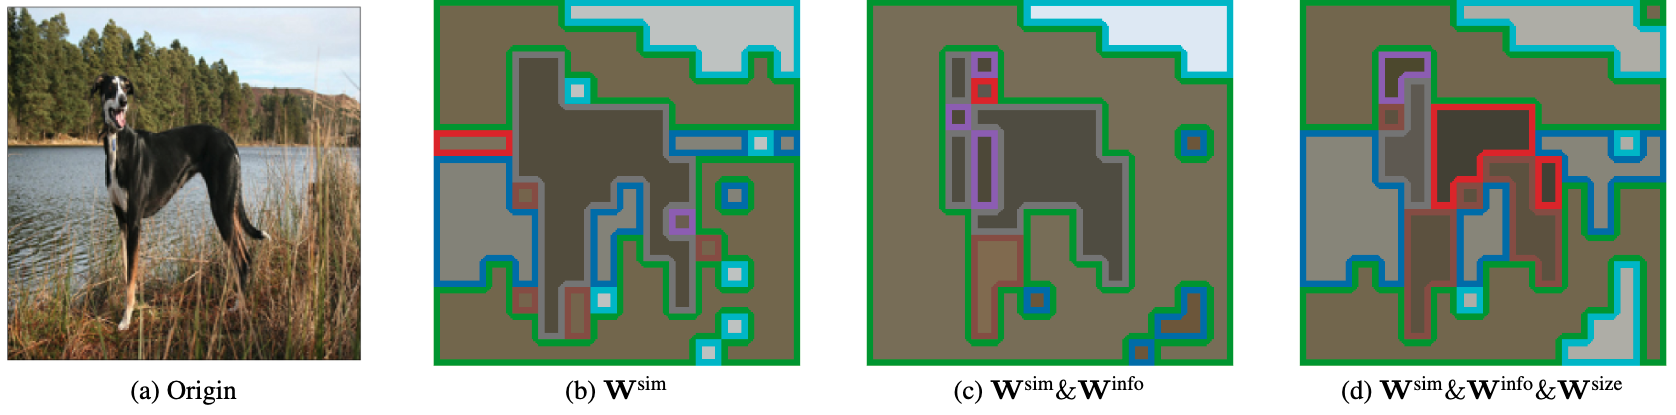
Official implementation of CVPR 2024 paper "Multi-criteria Token Fusion with One-step-ahead Attention for Efficient Vision Transformers".
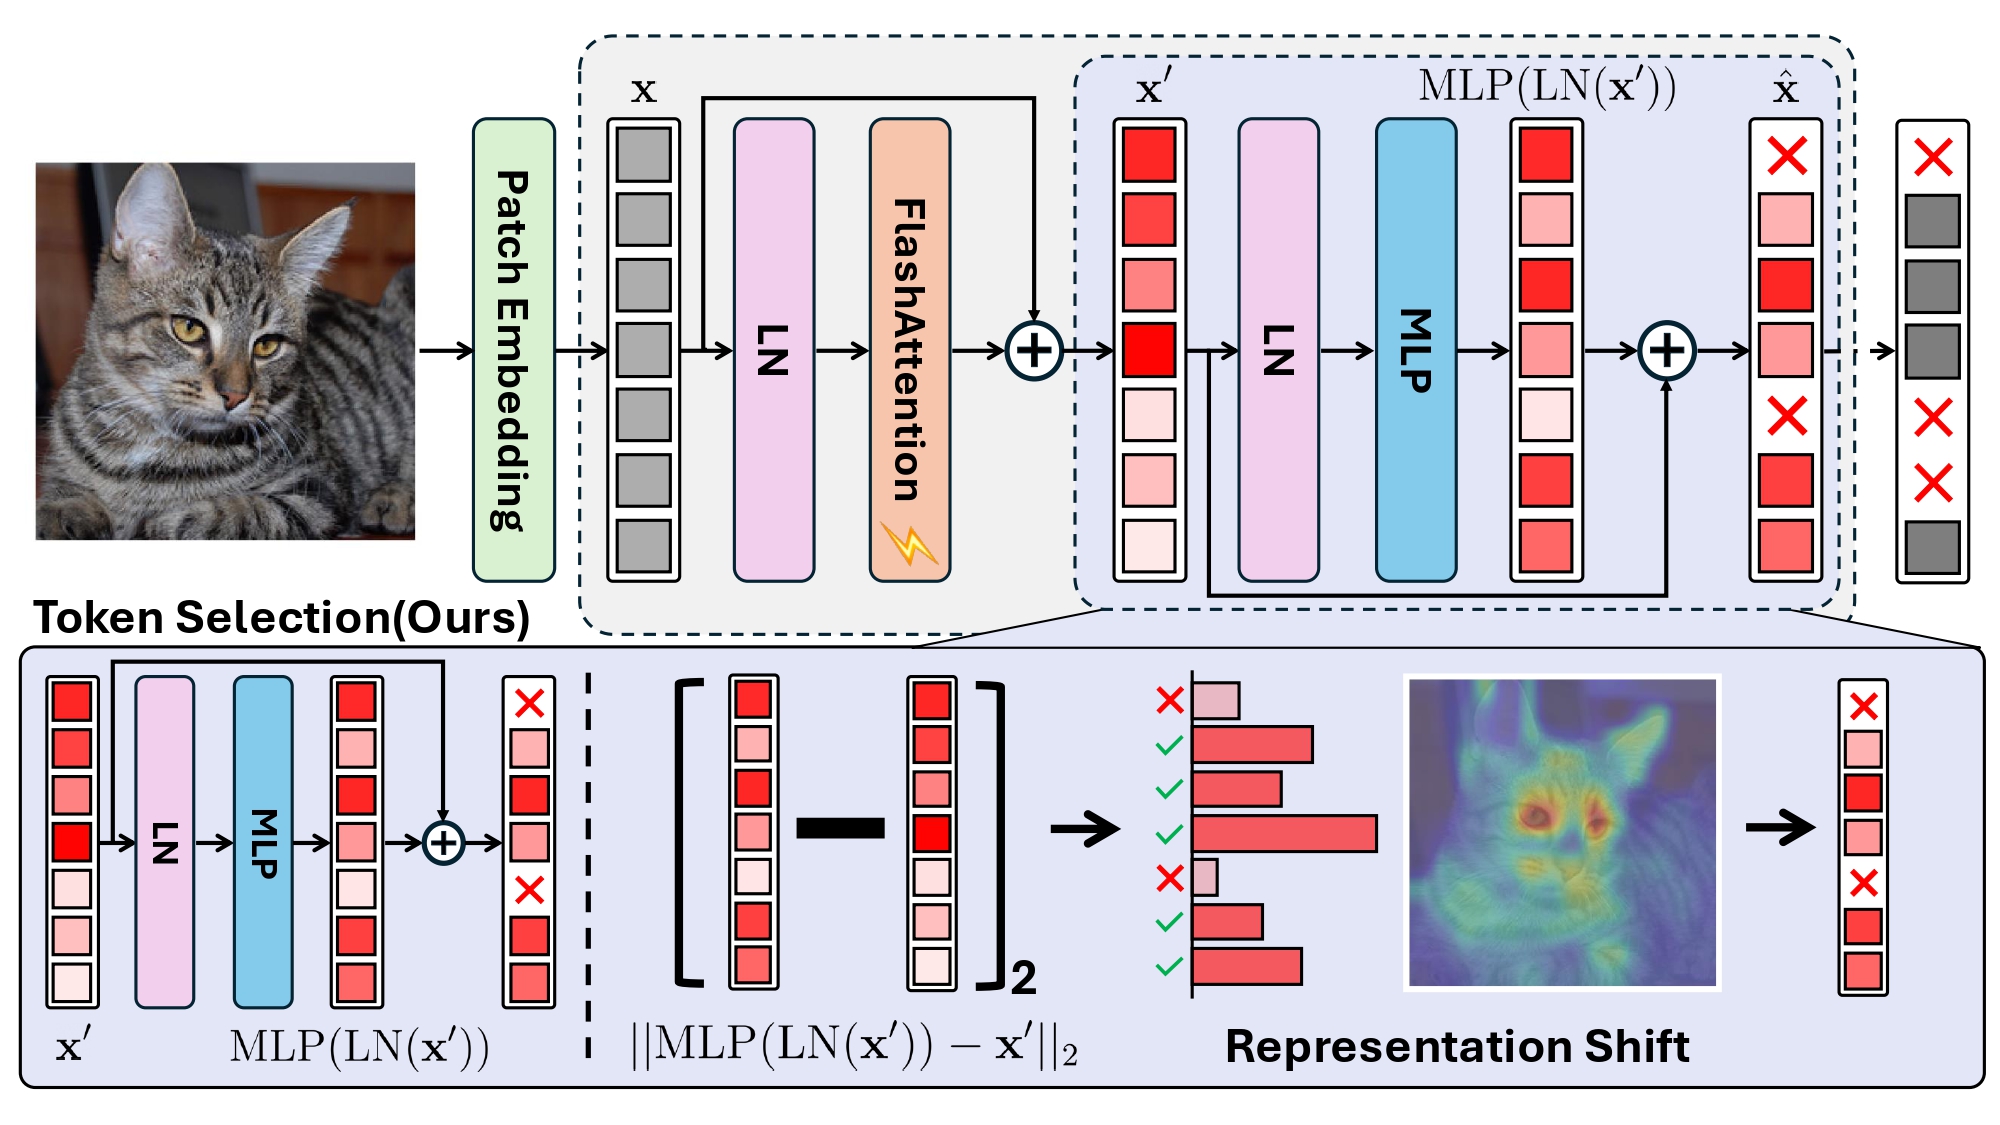
Official Implementation (Pytorch) of the "Representation Shift: Unifying Token Compression with FlashAttention", ICCV 2025
Demo code for CVPR2023 paper "Sparsifiner: Learning Sparse Instance-Dependent Attention for Efficient Vision Transformers"