lightly-train
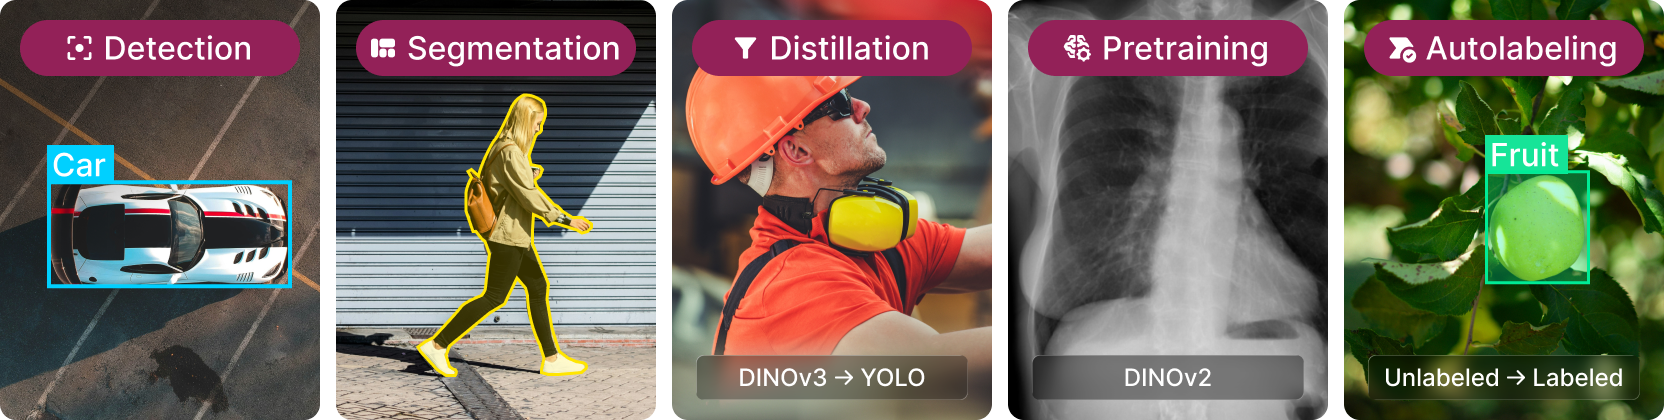
All-in-one training for vision models (YOLO, ViTs, RT-DETR, DINOv3): pretraining, fine-tuning, distillation.
- 1.7k
- Python
- AGPL-3.0
- 8 d ago
All-in-one training for vision models (YOLO, ViTs, RT-DETR, DINOv3): pretraining, fine-tuning, distillation.
[CVPR 2025 Highlight] Official code and models for Encoder-only Mask Transformer (EoMT).
Image segmentation model, used with transformers.

