COSA
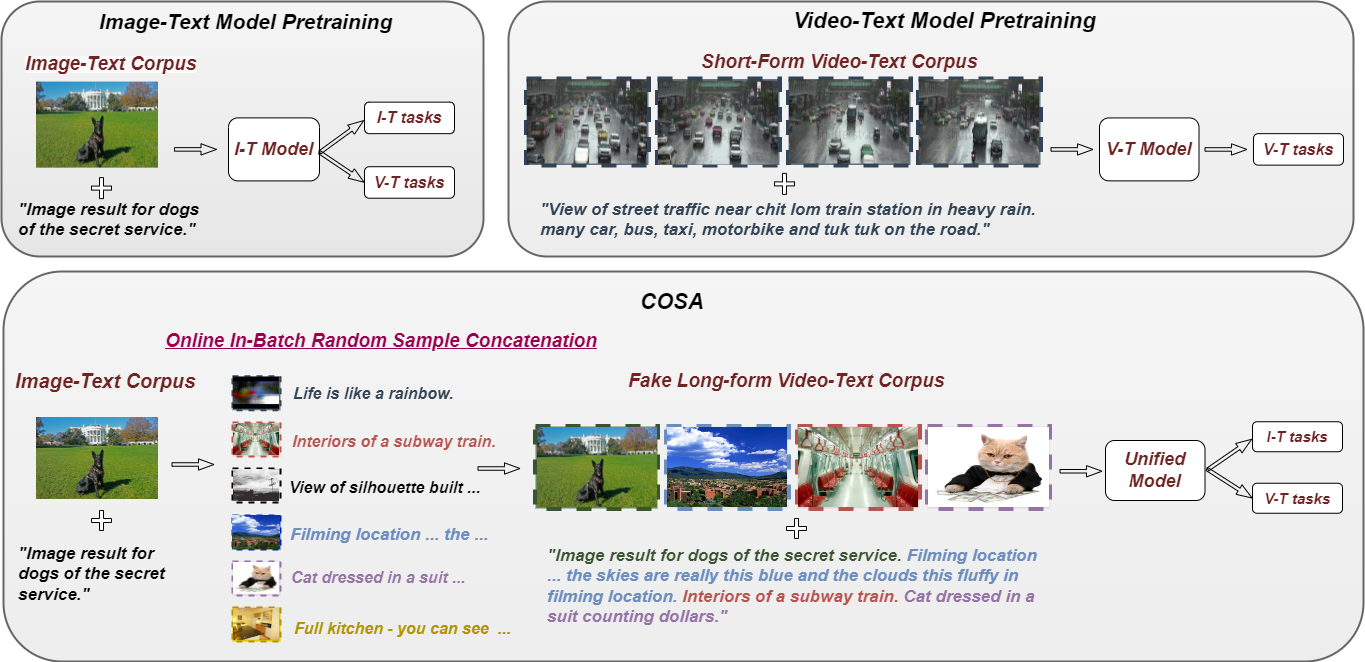
[ICLR2024] Codes and Models for COSA: Concatenated Sample Pretrained Vision-Language Foundation Model
- 44
- Python
- MIT
- 23 mo ago
[ICLR2024] Codes and Models for COSA: Concatenated Sample Pretrained Vision-Language Foundation Model
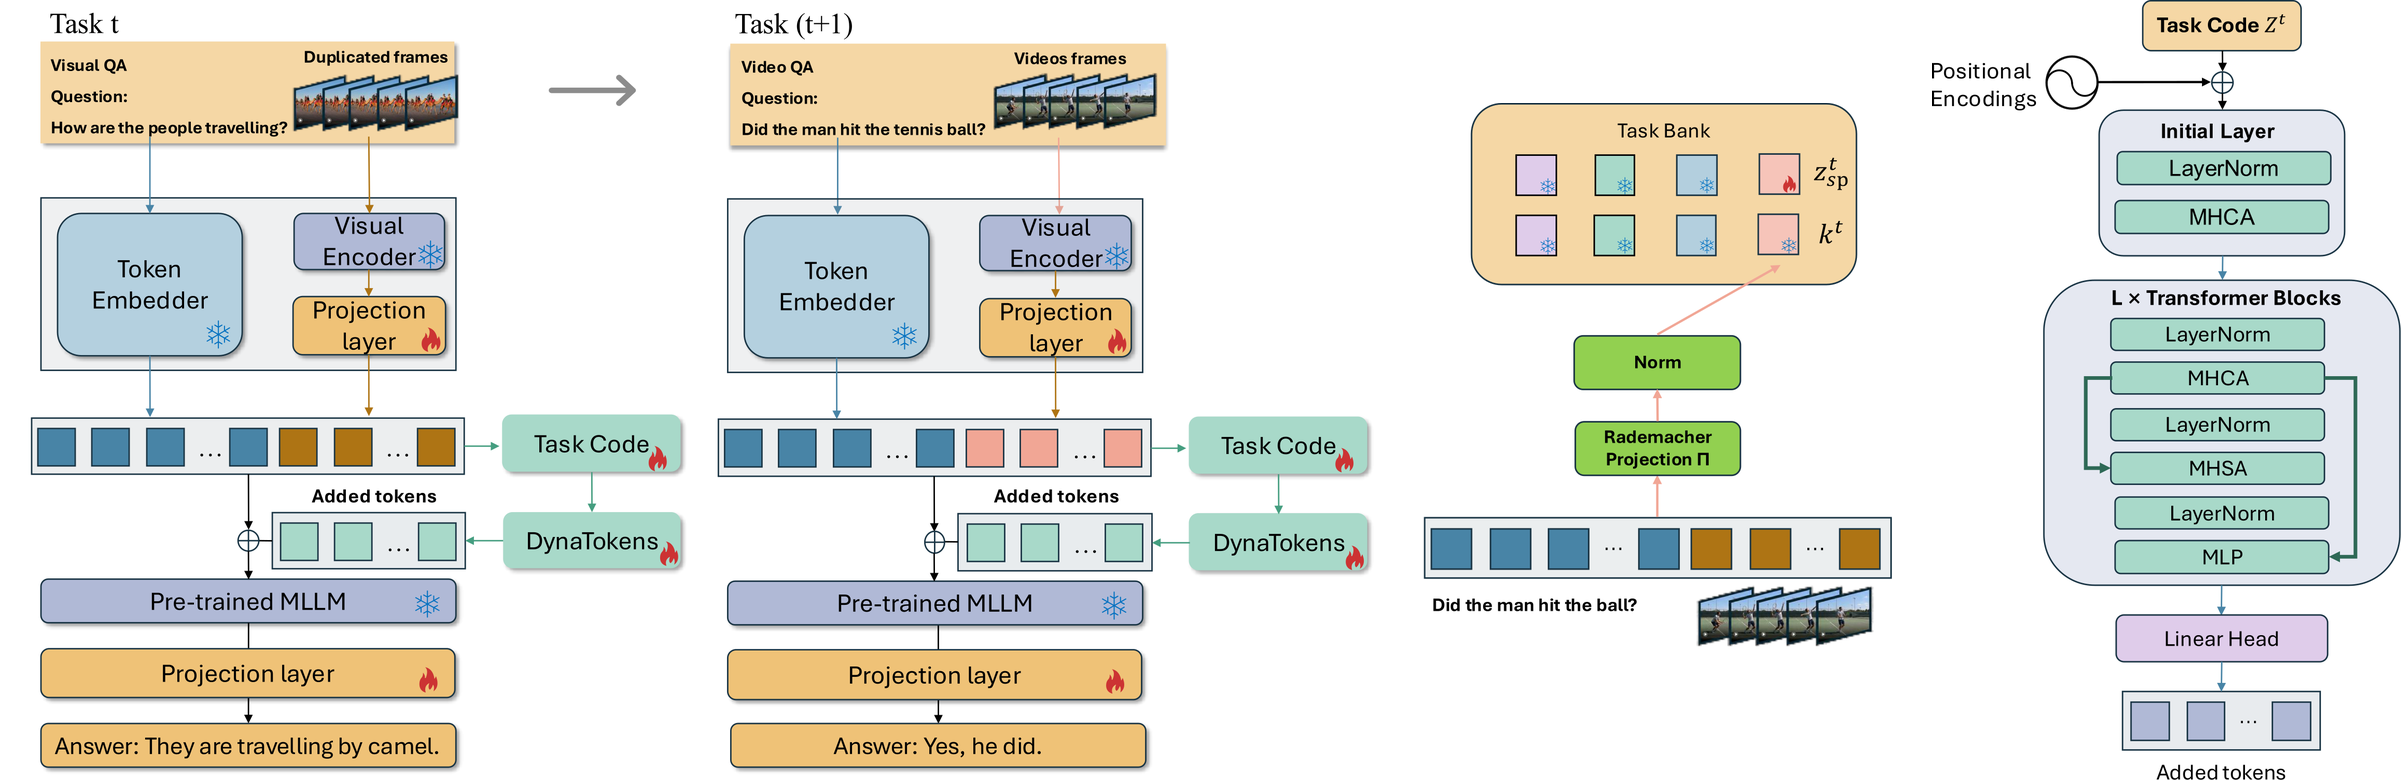
[EMNLP 2026] DynaTokens: Controlling Token Dynamics for Continual Video-Language Understanding
The teaches you to integrate text, images, and videos into applications using Gemini's state-of-the-art multimodal models. Learn advanced prompting techniques, cross-modal reasoning, and how to extend Gemini's capabilities with real-time data and API integration.